
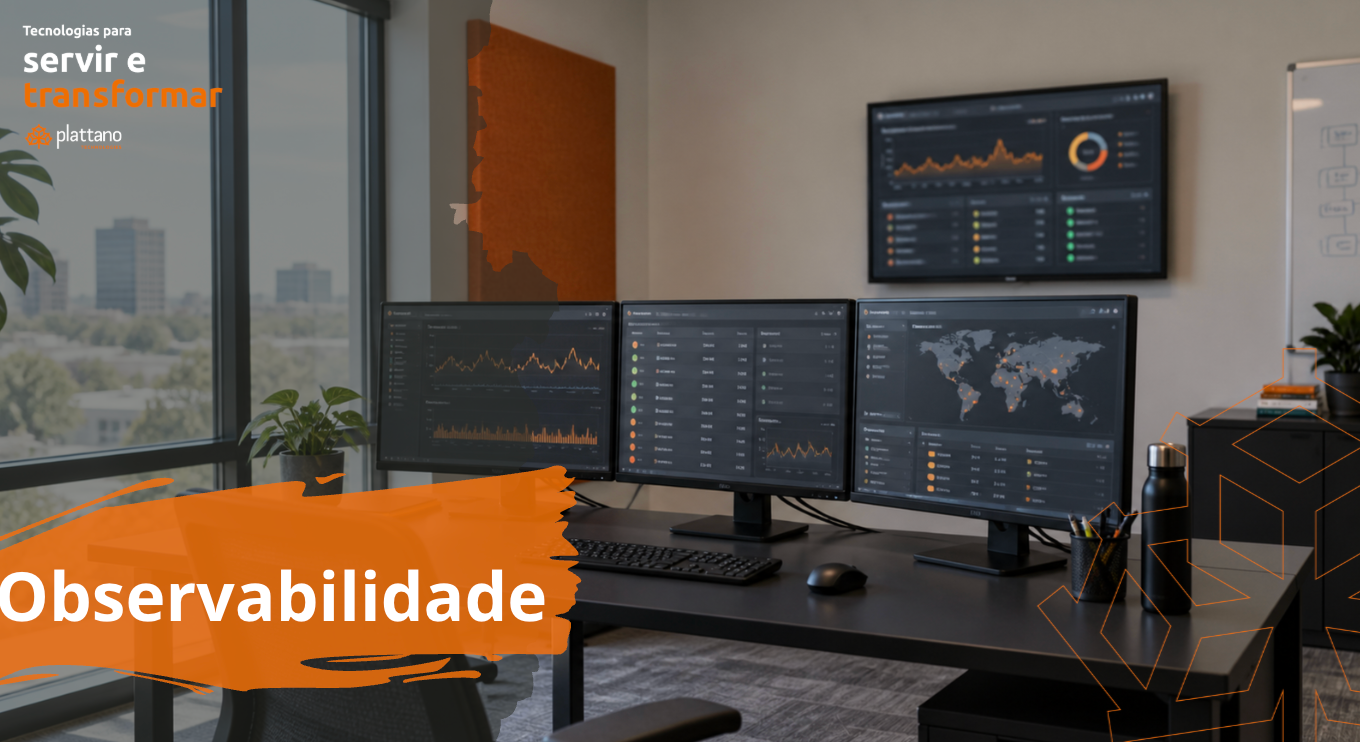
Tá tudo verde no meu dashboard!
Poucas coisas resumem tão bem a importância da observabilidade quanto essa situação.
O servidor está ligado. A CPU está tranquila. A memória está dentro do esperado. Só que alguém manda uma mensagem: “O sistema está lento”. E aí começa a investigação.
É a aplicação? O banco? A rede? Uma integração? Aquele deploy que “só mudou uma coisinha”?
Para mim, é aí que fica clara a diferença entre ter um ambiente funcionando e entender o que está acontecendo dentro dele.
Só saber que está no ar já não resolve!
Eu gosto de pensar assim: saber que um restaurante está aberto não me diz se os pedidos estão chegando à cozinha ou se a comida está saindo.
Em TI, acontece a mesma coisa. Um serviço pode estar disponível e, ainda assim, entregar uma experiência péssima.
Com aplicações distribuídas, nuvem, containers e integrações, uma ação simples do usuário pode passar por vários componentes. Quando alguma coisa dá errado no meio desse caminho, olhar apenas para o servidor é enxergar uma parte bem pequena da história.
Eu preciso entender o caminho inteiro.
E é aí que entra a observabilidade...
Sem complicar: observabilidade é conseguir entender o que está acontecendo dentro de um sistema a partir dos sinais que ele gera. Na prática, eu quero conseguir responder:
- O que deu errado?
- Quando começou?
- Quais usuários foram afetados?
- Por onde passou a requisição?
- O problema apareceu depois de alguma mudança?
Para investigar isso, três tipos de informação ajudam bastante: métricas, logs e traces.
As métricas mostram o comportamento: tempo de resposta, quantidade de erros, volume de acessos.
Os logs registram acontecimentos que ajudam a explicar o problema.
E os traces acompanham o caminho de uma requisição entre os serviços, mostrando onde ela demorou ou falhou.
O valor aumenta quando consigo conectar essas informações. Um gráfico mostra um pico de erros, eu encontro as requisições afetadas e vou atrás do contexto. A investigação ganha direção.
Ter ferramenta não significa ter clareza
Eu não vejo muito sentido em coletar uma montanha de dados se, na hora do problema, ninguém sabe onde procurar. Também não adianta criar tantos alertas que a equipe começa a ignorar todos eles.
Para mim, o começo é entender o que realmente importa para quem usa o sistema. O login funciona? O pagamento é concluído? A integração entrega os dados no prazo?
A partir daí, fica mais fácil decidir o que medir, quais informações registrar e quando vale a pena acordar alguém de madrugada. E tem outro cuidado: coletar tudo pode sair caro e expor dados que nem deveriam estar nos registros. Observabilidade também exige critério.
## Eu prefiro investigar com contexto
Nenhuma ferramenta vai impedir todos os incidentes. Mas ter informações úteis e conectadas pode diminuir bastante o tempo entre “deu problema” e “entendemos o que aconteceu”.
Além de ajudar na resposta, isso dá uma base melhor para avaliar mudanças, encontrar gargalos e planejar capacidade.
É por isso que eu considero observabilidade parte da construção de um ambiente de TI confiável.
No fim, eu quero olhar para o ambiente e entender se ele está entregando o que as pessoas precisam.
Porque painel verde é bom. Cliente conseguindo usar o sistema é melhor ainda.